差异表达分析:使用 R 进行 RNA-Seq 数据分析
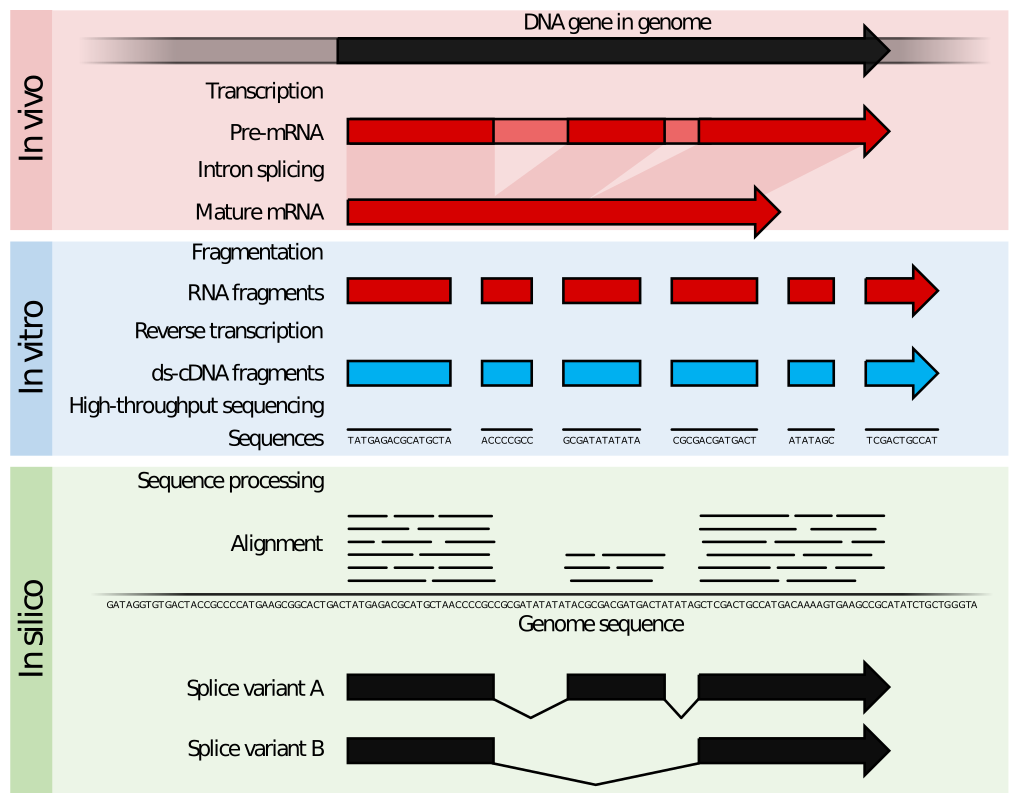
在现代生物学研究中,RNA-Seq(RNA测序)已经成为解析基因表达的强大工具。差异表达分析是其中一个重要步骤,通过比较不同条件下的基因表达水平,我们可以找出哪些基因在不同的生物条件下表现出显著变化。

差异表达分析
差异表达分析(Differential Expression Analysis)是指通过比较不同条件或处理下的基因表达水平,找出那些显著变化的基因。这些基因的变化可能与某些生物学过程、疾病状态或环境响应有关。
使用的软件包
- `limma`:用于线性模型拟合和差异表达分析。
- `edgeR`:用于 RNA-Seq 数据的标准化和处理。
- `dplyr`:用于数据操作。
函数实现
在此我们将构建一个名为 `runLimma` 的函数,该函数的输入参数为:
- 表达矩阵(`exp`)
- 样本分组信息(`group`)
- 是否执行标准化(`normalize`)
- 是否生成有方向的对比(`directional`)
其能够:
- 处理 RNA-Seq 数据的归一化
- 生成详细的结果总结
- 自动生成所有可能的对比矩阵,考虑所有组别之间的对比
让我们一步步讲解这个函数是如何工作的。
数据准备和输入
首先,我们需要准备两个输入:
- `exp`:表达矩阵,行代表基因,列代表样本。
- `group`:分组信息,每个样本对应一个实验条件或组别。
分组信息和设计矩阵
我们将分组信息转换为因子向量,并创建设计矩阵。设计矩阵用于描述实验的设计和条件,告诉我们哪些样本属于哪一组。
RNA-Seq 数据归一化
RNA-Seq 数据通常需要标准化,以便减少技术变异的影响,使不同样本之间的基因表达水平可以更准确地比较。但是如果数据已经经过了标准化,我们可以跳过这一步:
这里我们使用 `edgeR` 包中的 `DGEList` 和 `calcNormFactors` 函数对数据进行标准化处理。`voom` 函数进一步处理数据,使其适用于线性模型分析。
线性模型和经验贝叶斯分析
接下来,我们使用 `lmFit` 和 `eBayes` 函数进行线性模型拟合和贝叶斯统计。这一步帮助我们找到在不同组别间显著变化的基因。
生成对比矩阵
我们自动生成所有可能的对比矩阵,考虑所有组别之间的对比。
对比矩阵帮助我们定义哪些组别之间进行比较。
如果 `directional` 设置为 `TRUE`,函数会生成双向对比(例如 `N-T` 和 `T-N`),否则只生成一个方向的对比(可能是 `N-T` 或 `T-N`)。
应用对比矩阵并生成详细结果
使用生成的对比矩阵,我们可以对数据进行差异表达分析,并生成详细的结果总结,包括每个对比下的显著变化基因及其调控方向(上调或下调)。
提取结果
`getSummary` 函数用于打印某个对比的总结信息。
`getDEGs` 函数用于根据指定的 p-value 阈值(默认 0.05)、指定的 fdr 阈值(默认 0.05)和 logFC 阈值(默认 1)获取某个对比中的差异表达基因。
为了获取所有基因来绘制火山图,我们可以对此函数稍作修改:
当 `pvalue_threshold == fdr_threshold == logFC_threshold == NULL` 时,获取所有的基因
绘制火山图
`limma` 包的分析结果中,虽然最后一列 `Regulation` 已经标注了基因的上下调信息,但它仅仅是根据 `logFC` 列的正负来标注的,所以我们新建一列重新标注:
使用 `ggplot2` 绘图:
也可以写成函数:
+++info 关于 sym() 和 !! 的用法
在 R 语言中,`sym()` 和 `!!` 这两个概念属于非标准评估(non-standard evaluation, NSE)的范畴,这是一个非常强大但稍显复杂的主题,特别是在处理动态变量名时非常有用。
- `sym()` 函数
`sym()` 函数是 `rlang` 包提供的一个工具,用于将字符串转换为符号(symbol)。在 R 中,符号是一种对象类型,用于在表达式中代表变量名。
- **用途**:当你需要将字符串动态转换为可以由函数理解的变量名时,`sym()` 就非常有用。例如,如果你有一个变量的名称存储为字符串,而你需要用这个变量名在 `ggplot2` 或 `dplyr` 的函数中指定数据列,这时就需要用到 `sym()`。
- `!!` 运算符(读作“bang-bang”)
`!!` 是 `rlang` 包中的一个运算符,用于在函数内部`强制展开`符号,使其在表达式中被当作实际的变量名处理。
- **用途**:`!!` 使得你可以在编写通用函数或包含变量输入的函数时,将符号作为实际的变量名在表达式中使用。这在使用如 `ggplot2`、`dplyr` 等包进行编程时尤其有用,因为这些包经常使用非标准评估。
- 示例
假设你有一个数据框 `df`,并且你想根据用户的输入来选择哪一列进行操作。用户的输入是一个字符串,如 `"height"`。你不能直接在如 `ggplot` 或 `dplyr` 的函数中使用 `"height"` 字符串,因为这些函数期望的是列名,而不是包含列名的字符串。这时,你可以使用 `sym()` 和 `!!`:
在这个例子中:
- `sym(column_name)` 将字符串 `"height"` 转换为符号 `height`。
- `!!height_symbol` 在 `summarise()` 函数中将符号 `height` 展开为实际的列名。
这样,你就可以根据字符串变量动态地引用数据框中的列,而无需硬编码列名。这对于编写灵活且可重用的数据处理和可视化代码非常重要。
+++
如果我们想为一些基因添加注释,可以使用 `geom_label()` 或 `geom_text()` 添加注释图层,这两个函数的区别在于,`geom_text()` 将文本直接叠加到图像中,而 `geom_label()` 添加的文本有一个矩形框背景,可以更好地提升文本的可读性。
但是在实际的应用中,由于标签重叠等问题,更常用的是 `ggrepel` 包中的 `geom_label_repel()` 或 `geom_text_repel()` 函数:
修改后的 `volcanoPlot()` 函数:
完整代码
下面是完整的函数代码:
结果解读
通常经过差异表达分析我们会获得如下结果:
我们来逐列解释这些结果:
- **logFC**(对数折叠变化,Log Fold Change):
- logFC 表示目标基因在不同条件(如实验组和对照组)之间表达水平的对数变化值,通常以 2 为底数。其负值表示在实验组中下调,正值表示上调。
- 例如,如果我们做了一个肿瘤组织(T)与癌旁组织(N)的差异表达分析(T-N):如果 $logFC>0$,即 $log_2FC>0$,即 $FC>1$,也就是说 $\frac{T 的表达水平}{N 的表达水平}>1$,所以 T 组上调。
- **AveExpr**(平均表达值,Average Expression):
- 这是基因在所有样本中的平均表达水平。
- 例如,MESDC2 的 `AveExpr` 为 5.2581480,表示其在所有样本中的平均表达值为 5.2581480。
- **t**(t 统计量,T-statistic):
- 这是用于检验基因表达差异显著性的 t 检验统计量。
- 例如,MESDC2 的 `t 值` 为 -9.940661,表示其在对照组和实验组之间的表达差异非常显著。
- **P.Value**(P 值,P-Value):
- 这是 t 检验的原始 P 值,表示基因表达差异的显著性水平。较小的 P 值表示差异更显著。
- 例如,MESDC2 的 `P 值` 为 3.711317e-19,表示其表达差异极其显著。
- **adj.P.Val**(调整后的 P 值,Adjusted P-Value):
- 这是经过多重检验校正后的 P 值(例如,使用 Benjamini-Hochberg 方法)。调整后的 P 值用于控制假阳性率。
- 例如,MESDC2 的 `调整后的 P 值` 为 7.509108e-15,仍然表示其表达差异非常显著。
- **B**(B 统计量,B-Statistic):
- 这是基于贝叶斯统计方法计算的 B 值,用于估计基因为差异表达基因的概率。较高的 B 值表示更高的可信度。
- 例如,MESDC2 的 `B 值` 为 32.68792,表示其差异表达的可信度非常高。
- **Regulation**(调控方向,Regulation):
- 这是根据 logFC 的符号确定的调控方向,“Up” 表示上调,“Down” 表示下调。
- 例如,MESDC2 的调控方向为 “Down”,表示其在实验组中表达下调。
通过上述结果,我们可以看到几个基因在对照组和实验组之间的表达差异显著。例如,MESDC2 的表达在实验组中显著下调,而 GUCA2A 的表达在实验组中显著上调。调整后的 P 值和 B 统计量进一步验证了这些差异的显著性和可信度。
Loading...