使用网络方法识别疾病模块
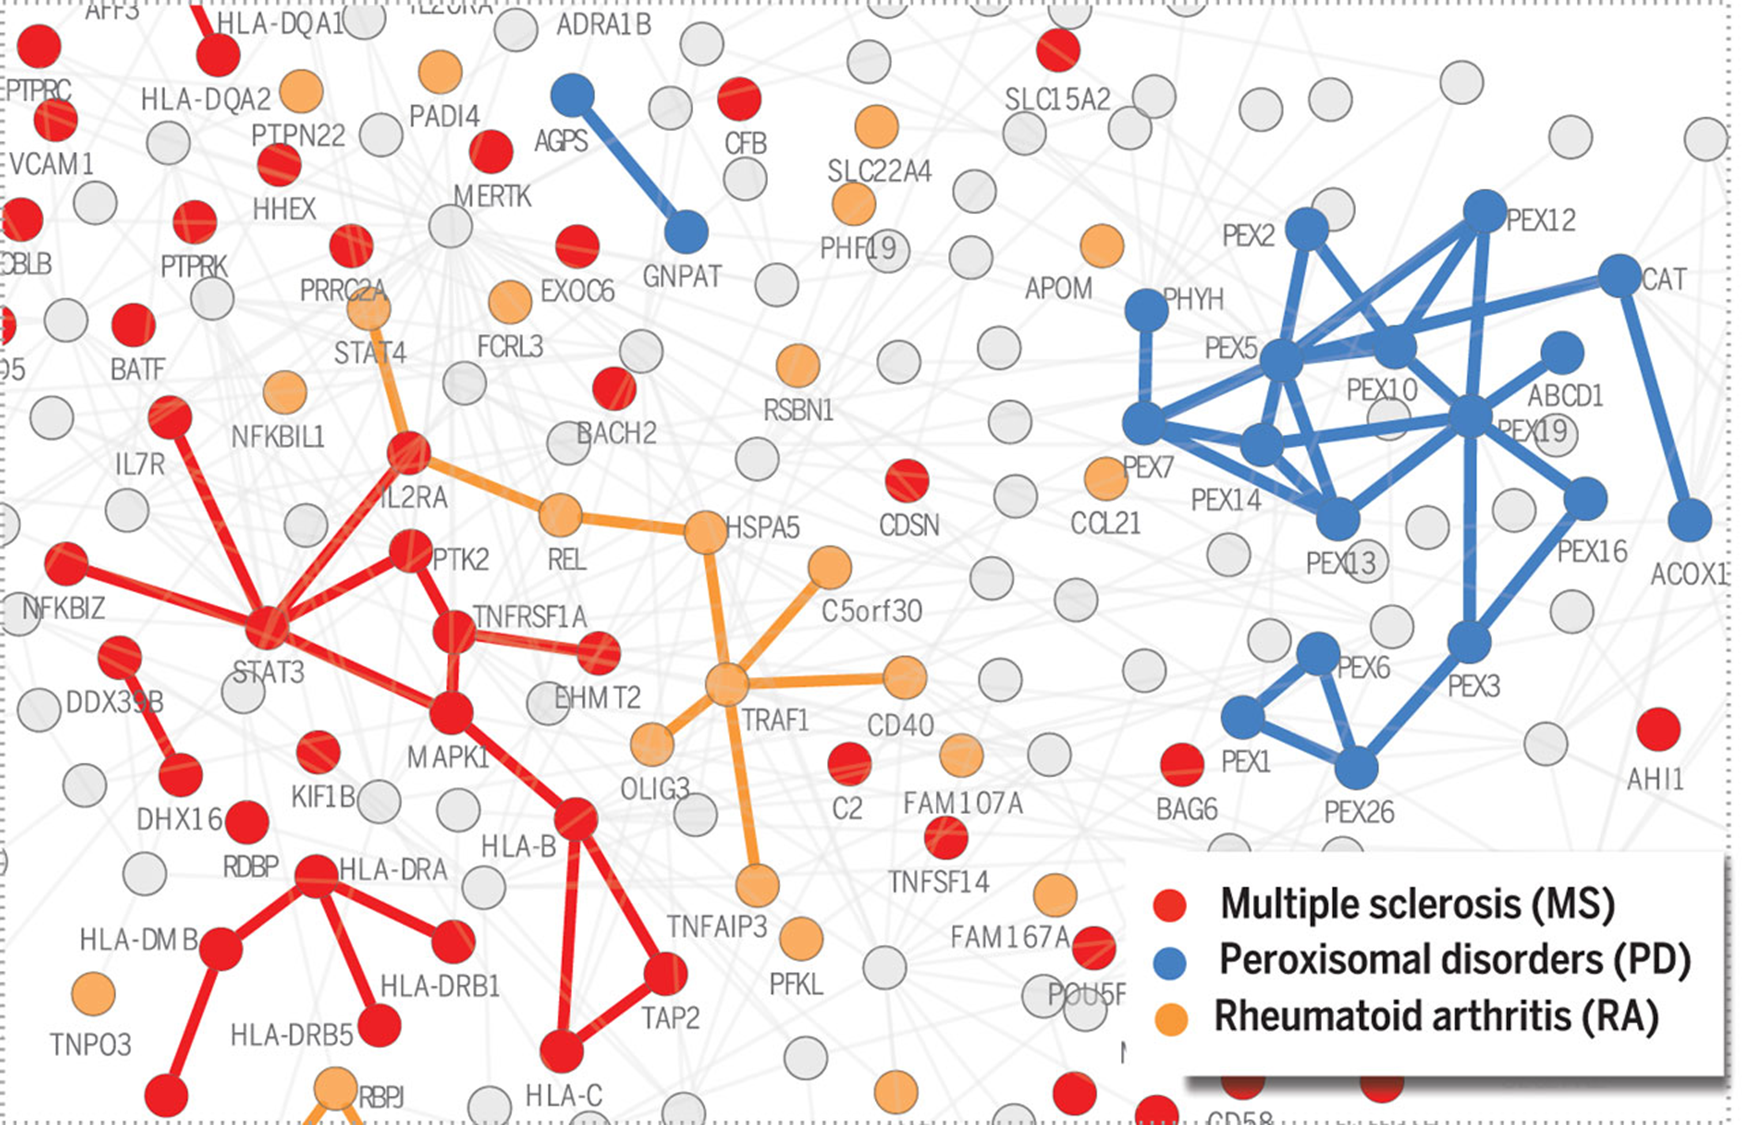
在 2015 年的一篇 Science ["Uncovering disease-disease relationships through the incomplete interactome"](https://www.science.org/doi/full/10.1126/science.1257601) 中,作者提出了一种基于网络距离的方法来识别和分析疾病模块,并揭示疾病之间的关系。
背景
疾病不是由单个基因异常直接导致的,而是由多个分子过程的相互作用所引起的。这些过程之间的关系被编码在相互作用网络(interactome)中,这个网络集成了细胞内所有的物理相互作用,包括蛋白质-蛋白质、调控蛋白质-DNA 和代谢相互作用。
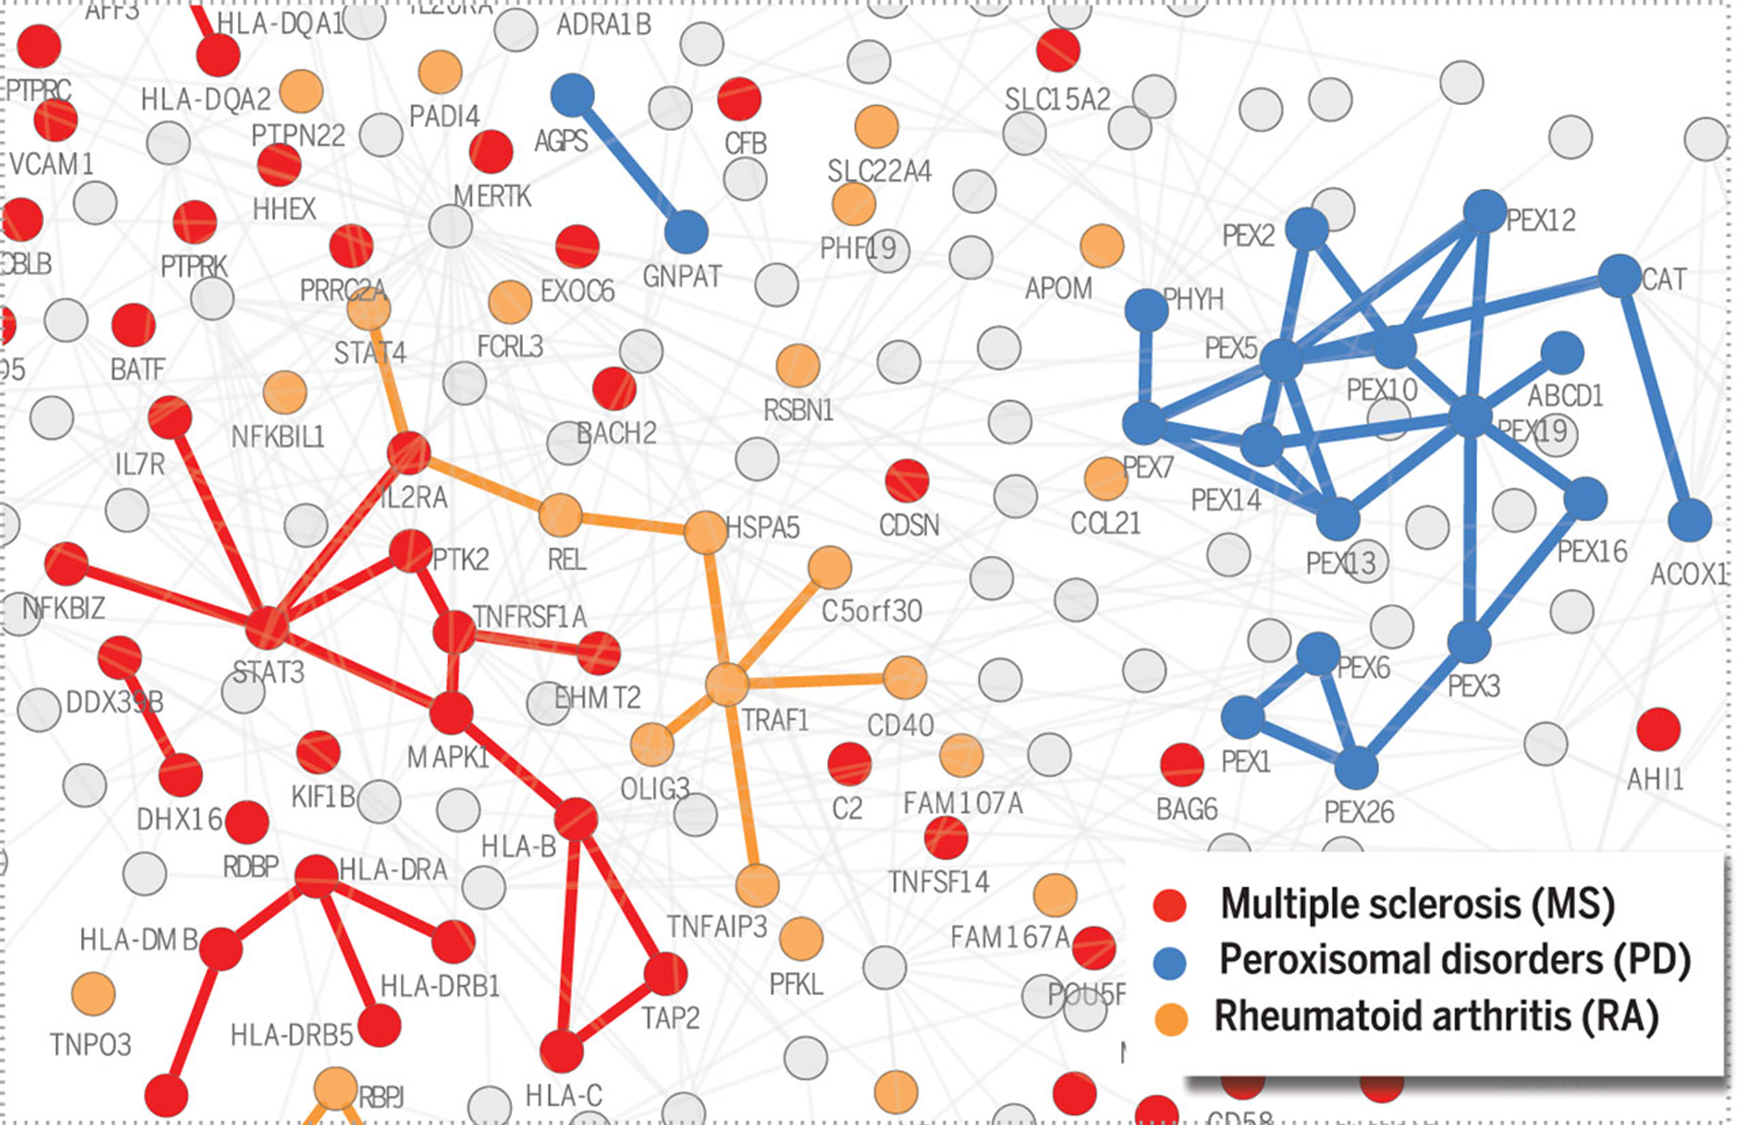
研究表明,疾病相关的蛋白质往往聚集在相互作用网络的同一邻域内,形成一个疾病模块。
研究显示只有当与疾病相关的基因数量超过某个临界值时,我们才能揭示疾病模块。研究发现,与 226 种疾病相关的蛋白质在同一网络邻域内聚集,表现出显著的形成可识别疾病模块的趋势。疾病蛋白质在网络中的聚集程度越高,相应基因的生物学和功能相似性越高。
方法
文章的补充文件中提供了两个 Python 脚本:
separation.py
这个脚本用于计算基于网络的距离 $d_{AB}$ 和分离度 $s_{AB}$ ,用以表示两个给定基因集 $A$ 和 $B$ 在给定网络上的相对位置和分离度。
localization.py
此脚本的主要功能是计算一个给定基因集在相互作用网络中的本地化特性。它会计算以下 3 个指标:
- **最大连通子图的大小 (S)**:给定基因集在相互作用网络中形成的最大连通子图(LCC)的大小。
- **平均最短路径长度 (d_s)**:基因集内所有基因对之间的平均最短路径长度。
- **随机期望值**:通过随机模拟生成相同数量的基因集,并计算这些随机基因集的最大连通子图大小的期望值和标准差,然后比较实际基因集的结果,输出 z-score。
然而,给出的代码都是基于 Python2 语法的,现在主流的 Python 版本是 Python3,所以我用 Python3 的语法重写了这两个脚本。
重写后的代码
separation_py3.py
localization_py3.py
参考
- [Uncovering disease-disease relationships through the incomplete interactome](https://www.science.org/doi/full/10.1126/science.1257601)
Loading...